Что понадобилось, чтобы ИИ стабильно вытаскивал данные из фотографии счёта.
Последние пару дней собирал распознавание счетов для 1С.
Сначала пытался решить всё промптом. Жёстко описал каждое поле:
+ ИНН только 10 или 12 цифр;
+ БИК 9 цифр;
+ расчётный и корреспондентский счета по 20 цифр;
+ отдельно объяснил, кто в документе поставщик, а кто покупатель;
+ запретил путать счёт Банка России 401... с корреспондентским;
+ если значение не читается — лучше вернуть пустое поле, чем придумать.
Но быстро выяснилось, что больше инструкций ≠ лучше результат.
На одном из прогонов более подробный промпт даже ухудшил результат: 15/30 → 13/30 правильно извлечённых полей на одной и той же (слабенькой) модели.
Гораздо сильнее помогла работа с самим изображением.
Я начал увеличивать документ, отдельно вырезать шапку со сложными реквизитами и повторно отправлять в модель только те поля, которые не прошли проверку.
На моём тестовом наборе данных разница была очень заметна: например, ИНН с полной фотографии документа модель правильно читала только в 5–7 из 15, а с отдельного кропа 15 из 15 случаев.
После распознавания модели, для надёжности, сделал проверки обычном кодом:
+ проверка контрольной суммы ИНН;
+ проверка ОГРН;
+ банковский контрольный ключ счёта;
+ проверка связки БИК и корреспондентского счёта;
+ повторное распознавание полей, которые не прошли валидацию.
Если в документе есть QR и в нём содержатся нужные реквизиты, их логичнее брать оттуда, а распознавание изображение оставить как запасной вариант.
После этого я прогнал 19 разных вижн-моделей с опенроутера.
Тест небольшой, поэтому это не "топ-5 лучших моделей", конечно, но документы при этом разные: казначейский УФК, обычные коммерческий счёта без QR, счёт ИП – ИП без НДС, и т.д.
Эталон реквизитов собирал независимо от ответов ИИ из QR там, где он был, плюс сверка реквизитов и детерминированные банковские проверки.
Лучший результат в этом эксперименте показала Gemini 3.5 Flash-Lite: 30/30 в нескольких последовательных прогонах.
Её в итоге и оставил.
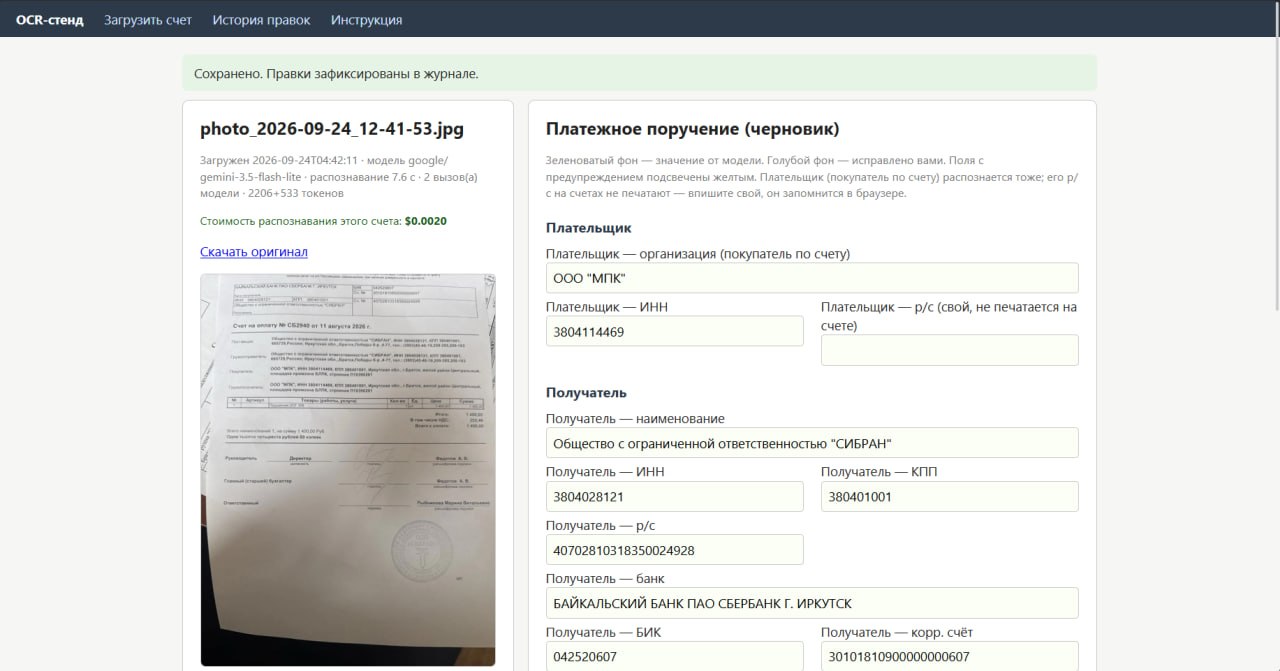
Сейчас собрал из получившейся программы сайт, и передал заказчику, с возможностью править данные в итоговой форме, что бы накопить статистику ошибок и косяков, для последующей доработки.
А теперь главный вывод.
Задача оказалась не в том, чтобы найти модель, которая "идеально распознает счета". Хорошей модели самой по себе недостаточно!
Нужна работа с исходным изображениям, ограничения на формат данных и довольно много скучного детерминированного кода вокруг.
Именно это в итоге и превращает красивую магию распознавания в данные, которые уже не страшно отправлять в 1С.
У Глеба Кудрявцева был похожий опыт, он собирал SOTAOCR
Можно найти на просторах сети.
А сама моделька доступна у Ковальского по API (neuraldeep)
Я тестил и мне не оч зашло, но я пытался рукописные тексты распознать, а печатные попроще
Я пробовал его решение. Не так хорошо работает по итогу, даже на старшей MAX (там две модели в ЛК после авторизации)
А я думал проблема в моих зачадах. Понял, спасибо