Как дела у моей локальной ИИ-модели
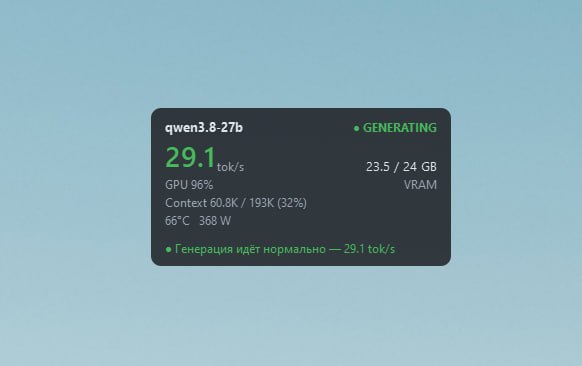
Виджет на рабочий стол, управление PI-харнесом с телефона и ревью кода, которое токены не жрёт, а нюхает. Как живётся локальной модели на RTX 3090.
Сборка машины для локальных LLM, RTX 3090, Qwen, настройка контекста и практика запуска моделей.
Виджет на рабочий стол, управление PI-харнесом с телефона и ревью кода, которое токены не жрёт, а нюхает. Как живётся локальной модели на RTX 3090.
Перед уходом домой запустил локальную нейросеть чинить баги на проекте. Пока-что она настроена не идеально, легко может уйти в бессмысленный и бесконечный цикл. Поэтому настроил автоматическое выключение компьютера…
Открываю ленту: + SFT-корпус на 0,7 млрд токенов, 5 эпох, 8×H100; + 100500 часов тестов на 4×5090, FP8, NVFP4, AWQ, 20 млн reasoning-токенов. И я. Сижу со своим Qwen на одной 3090 и думаю: ага, то есть я,…
Нет, не потому, что первая плохо справляется. Скорее наоборот. После прошлого поста ещё поигрался с настройками запуска и контекст удалось поднять до 164к токенов. Можно запускать и на 192к, но там уже придётся…
Короткий ответ: вполне серьёзную локальную альтернативу большим облачным LLM. Цена удовольствия: нужно вникать. Параметры запуска, кванты, софт, архитектура, инфраструктура и тонны тестов. Большие LLM дают комфорт,…
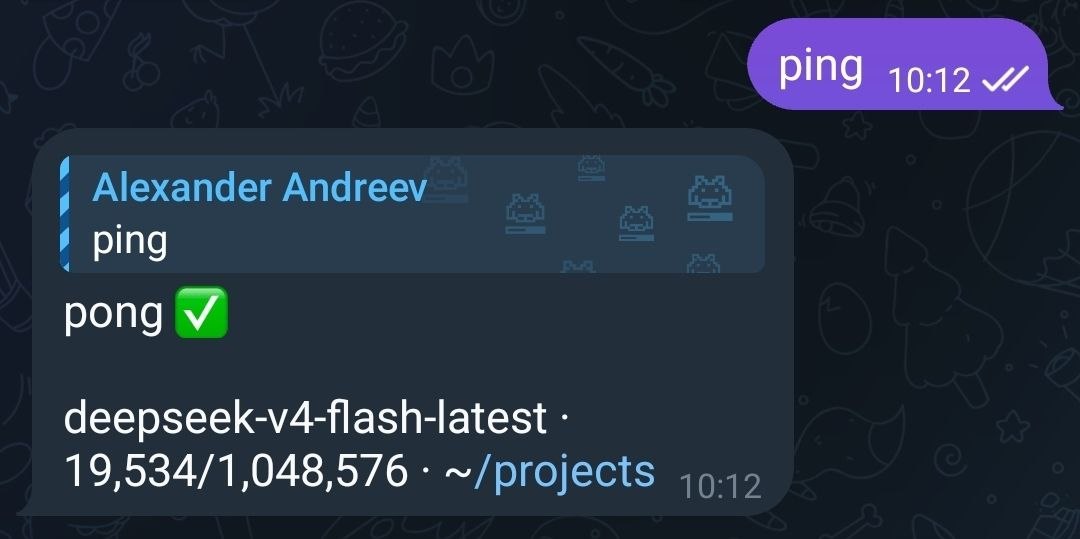
Промпт, которым обычно проверяешь, не отвалилась ли модель. Может VPN тупит, может что-то программно сломалось и т.д. Знаете, сколько контекстного окна отжирает этот промпт из одного слова у Гермеса? 20 тысяч…
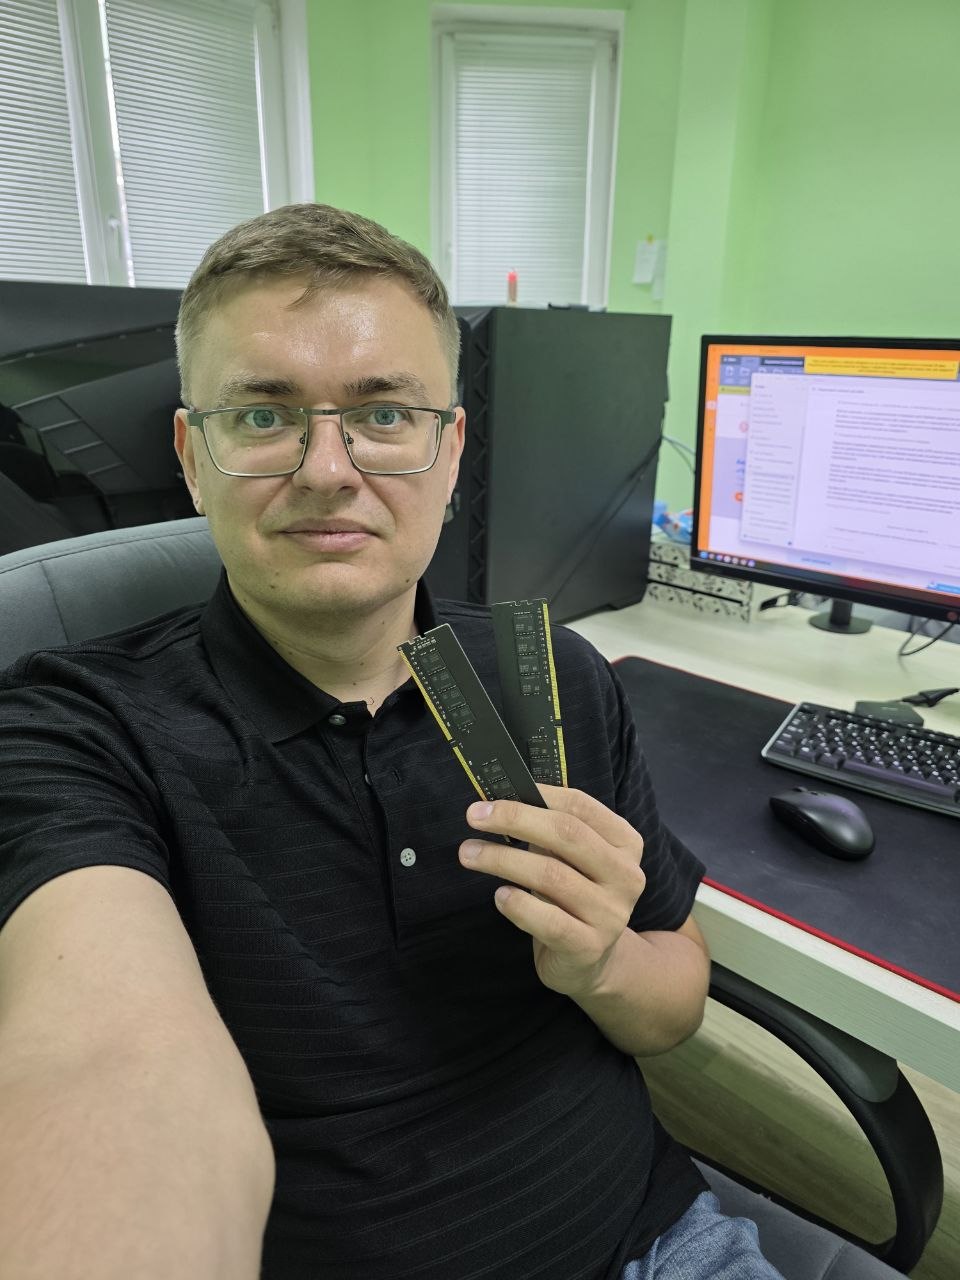
Теперь комплект для запуска LLM локально собран полностью. Радуюсь, как ребёнок)
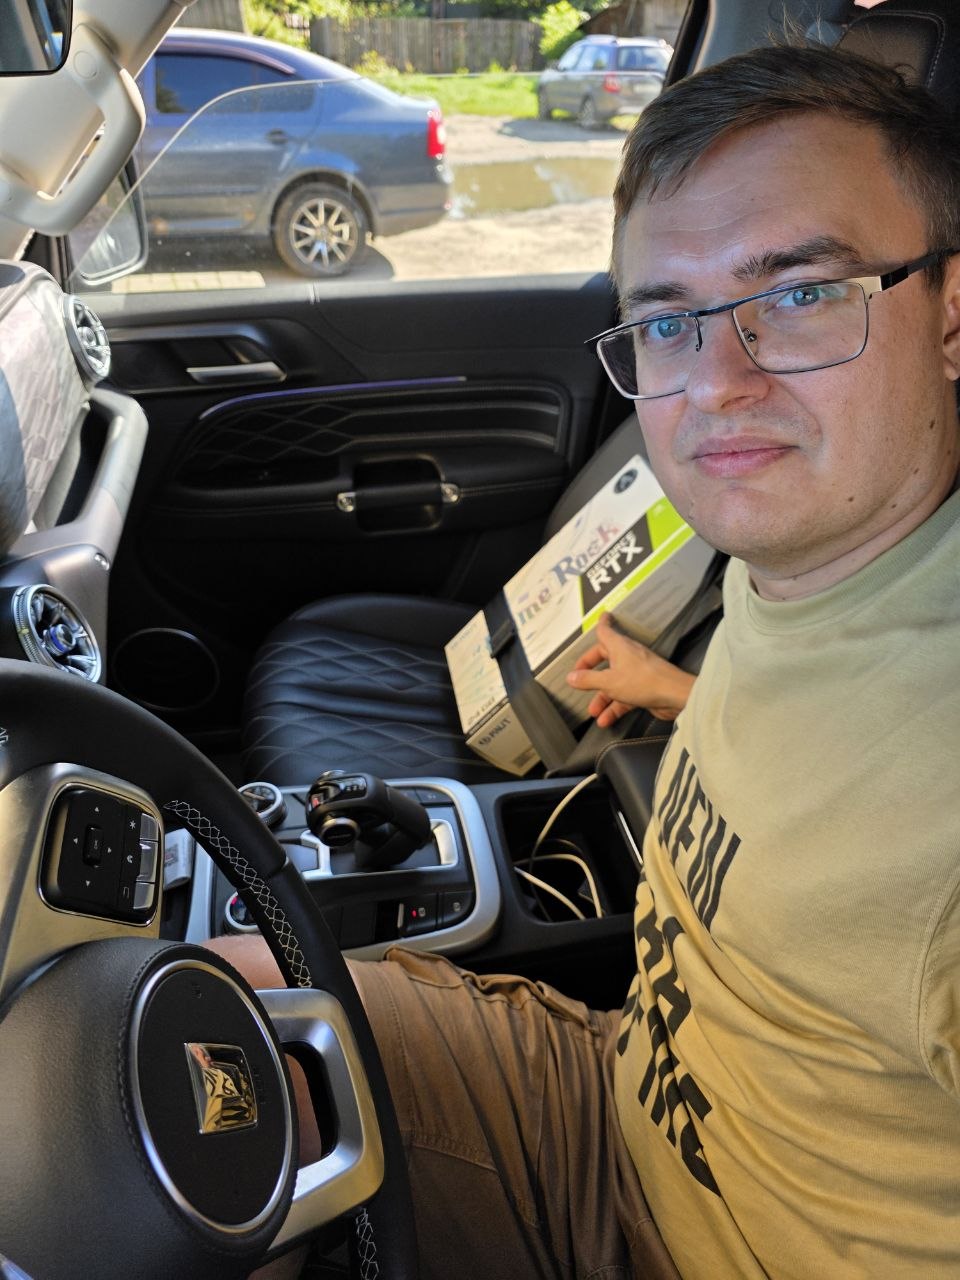
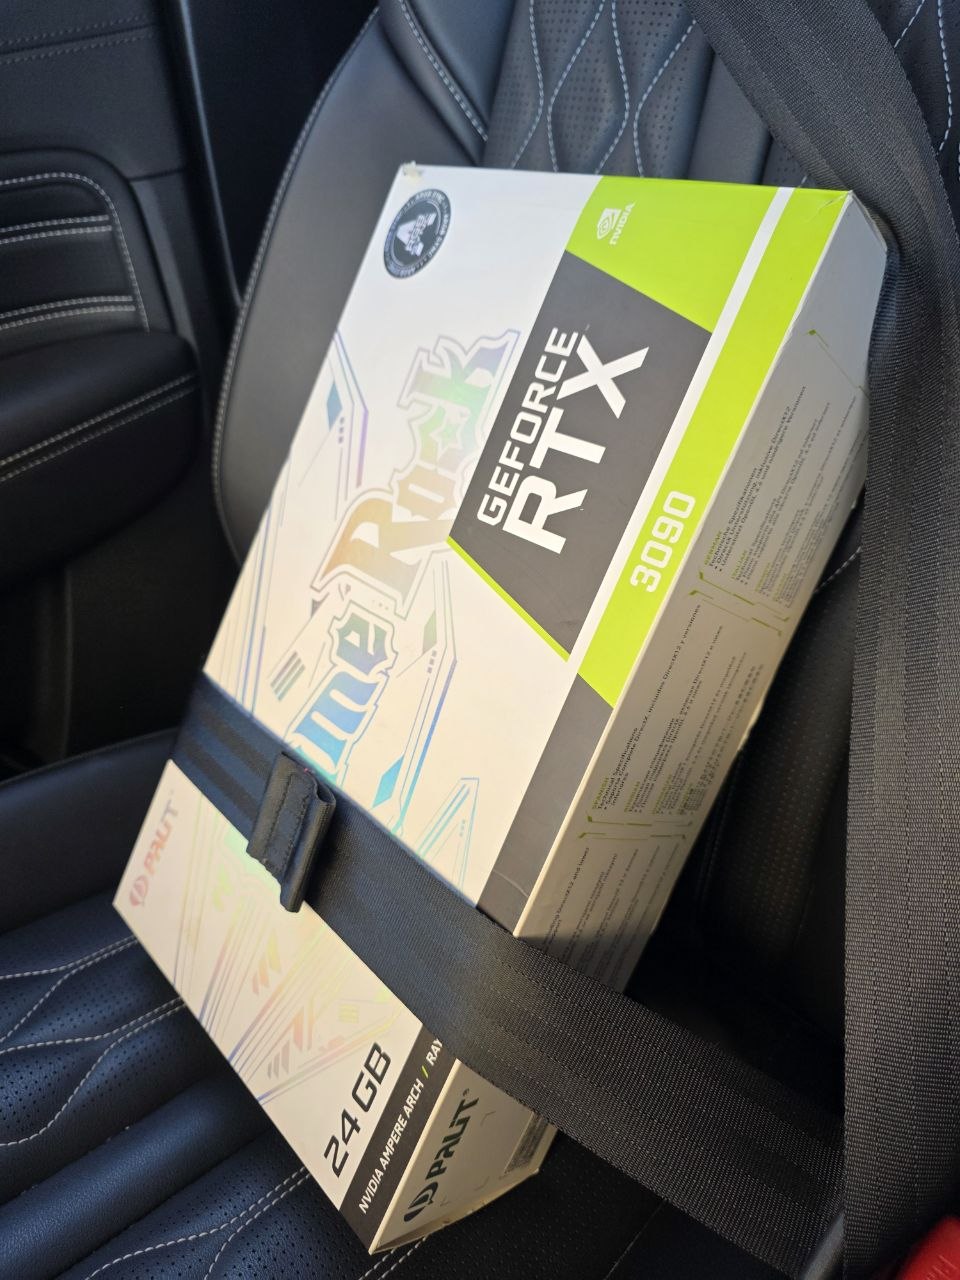
Чтобы проверить RTX 3090, пришлось купить киловаттный блок питания с тремя отдельными PCIe 8-pin и взять у друга системник, куда эта махина хотя бы физически помещается. Полчаса "бублик" FurMark-а с потреблением на…
Qwen 3.6-27B — неплохая модель для кодинга, если нормально её настроить. Она дороже DeepSeek V4 Flash, которую я сейчас использую для большинства повседневных задач. GPT-5.6 Sol при этом всё равно остаётся мозгами…